Modele MoE: cum rulează un LLM de 30B pe un PC cu 8 GB VRAM
Ce este un model Mixture of Experts, cum este construit Qwen3-30B-A3B din 128 de experți pe strat și ce viteză am măsurat pe un PC cu RTX 3060 Ti și 32 GB RAM.

Pe scurt
Un model MoE înlocuiește MLP-ul dens al fiecărui strat cu mai mulți experți mici și un router care alege câțiva pentru fiecare token. Qwen3-30B-A3B are 30,5 miliarde de parametri, dar folosește doar 3,3 miliarde per token: memoria cerută este a unui model de 30B, calculul și viteza sunt ale unuia de 3B. Pe un PC cu i5-6600K, 32 GB DDR4 și RTX 3060 Ti de 8 GB, unde modelul nu încape pe placă, am măsurat 19,4 tokeni pe secundă, față de 52,6 pentru Qwen3-8B rulat integral pe placă.
Un PC de birou din 2015: procesor Intel i5-6600K, 32 GB de RAM DDR4 și o placă video RTX 3060 Ti cu 8 GB de memorie. Pe el am rulat, prin Ollama, un model de limbaj cu 30 de miliarde de parametri, al cărui fișier are 19 GB și nu încape pe placa video. A generat text cu 19,4 tokeni pe secundă, adică mai repede decât citești. Același PC rulează Qwen3-8B, un model de aproape patru ori mai mic, cu 52,6 tokeni pe secundă.
Modelul se numește Qwen3-30B-A3B. Litera „A” din nume este toată explicația: din cele 30 de miliarde de parametri, pentru fiecare token sunt folosite doar 3 miliarde. Un model Mixture of Experts cere memoria unui model mare, dar face calculul, și deci are viteza, unui model mic. Restul articolului arată cum se obține asta și ce costă.
În articolul anterior am urmărit un token prin cele 36 de straturi ale lui Qwen3-8B, un model „dens”: toate numerele lui participă la fiecare token. Aici schimbăm un singur bloc din acel strat. Matematica rămâne cea de liceu, iar cifrele vin din fișierul de configurare al modelului, din raportul tehnic Qwen3 și din măsurători proprii, pe care le raportăm exact cum au ieșit, inclusiv o buclă de raționament fără sfârșit.
Ce înseamnă „30B-A3B”
| Caracteristică | Qwen3-30B-A3B | Qwen3-8B, pentru comparație |
|---|---|---|
| Parametri stocați | 30,5 miliarde | 8,19 miliarde |
| Parametri folosiți per token | 3,3 miliarde | 8,19 miliarde |
| Straturi | 48 | 36 |
| Dimensiunea vectorului intern | 2.048 | 4.096 |
| Capete de atenție (interogări / chei-valori) | 32 / 4 | 32 / 8 |
| Experți pe strat / activi per token | 128 / 8 | fără experți |
| Dimensiunea internă a unui expert | 768 | MLP dens de 12.288 |
| Context nativ | 262.144 tokeni (varianta 2507) | 32.768 |
| Fișierul din Ollama (Q4_K_M) | 19 GB | 5,2 GB |
Sursele: fișa modelului Qwen3-30B-A3B, fișierul de configurare și pagina qwen3:30b din Ollama. Observă că vectorul intern este de două ori mai mic decât la 8B, iar straturile sunt mai multe. Modelul este „mai îngust și mai lung”, iar grosimea lui stă în experți.
Stratul MoE: ce înlocuiește MLP-ul
În stratul dens, după atenție urmează MLP-ul: trei matrice de 4.096 × 12.288 prin care trece fiecare token, fără excepție. La Qwen3-8B, cele 151 de milioane de numere ale MLP-ului sunt trei sferturi din strat.
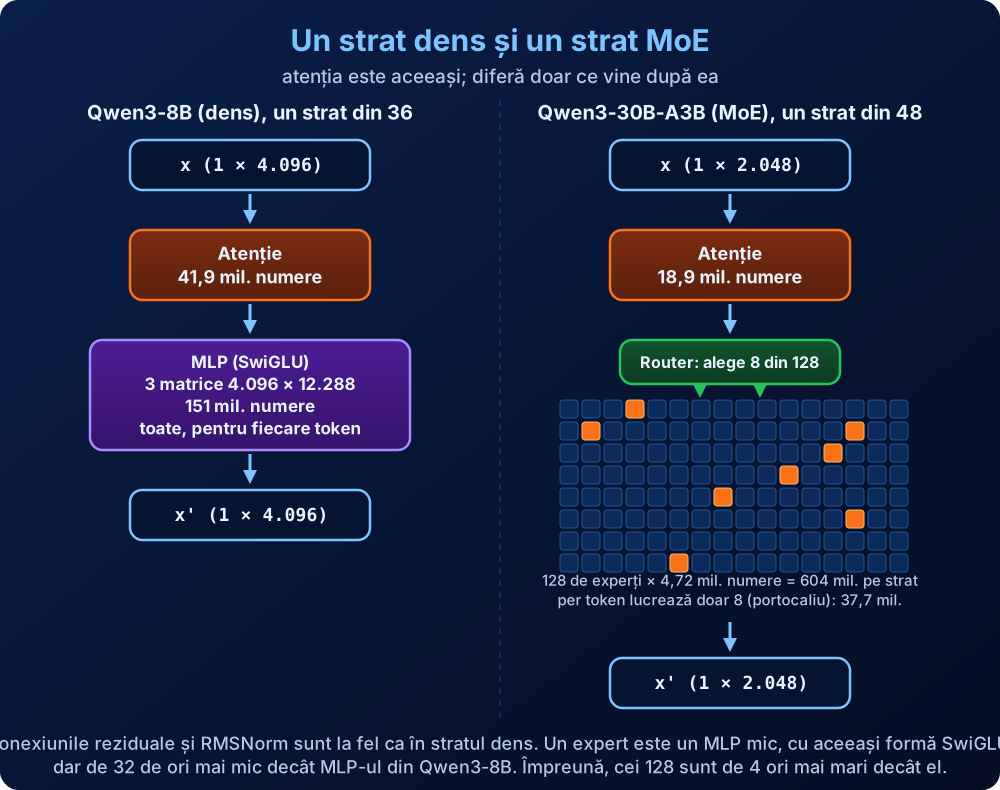
Într-un strat MoE, în locul unui singur MLP mare stau 128 de MLP-uri mici, numite experți, și un router. Pentru fiecare token, routerul alege 8 experți. Doar aceștia calculează; ceilalți 120 nu sunt nici măcar citiți din memorie pentru tokenul respectiv. Ideea are aproape trei decenii, dar a devenit practică pentru modelele de limbaj prin lucrările Shazeer și colab., 2017 și Switch Transformer, 2021, apoi a intrat în modelele publice prin Mixtral, cu 8 experți din care 2 activi, și în cele foarte mari prin DeepSeek-V3, cu 671 de miliarde de parametri din care 37 activi.
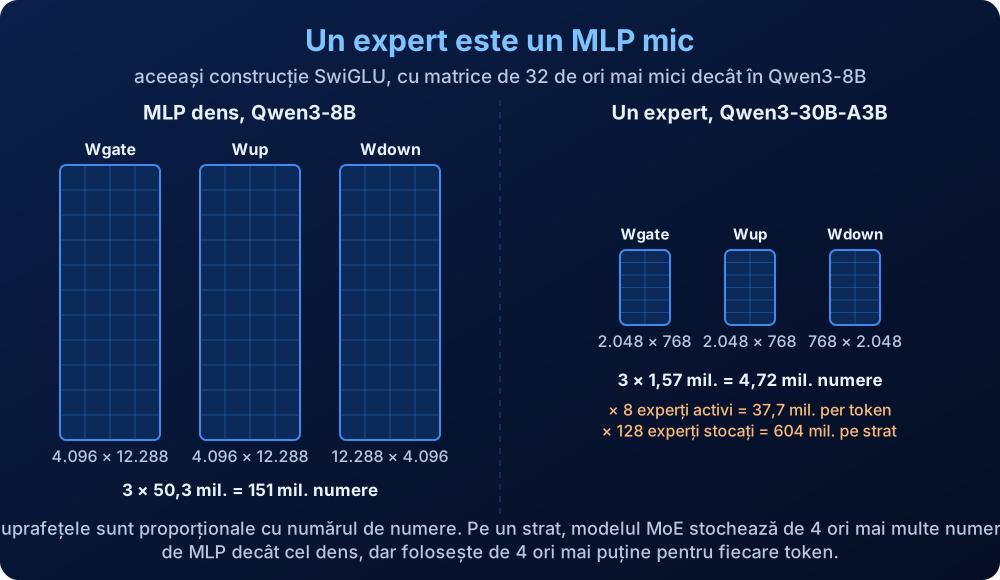
Un expert din Qwen3-30B-A3B este construit exact ca MLP-ul descris în articolul anterior: o matrice „poartă” și una de lărgire, de 2.048 × 768 fiecare, o funcție SiLU, o înmulțire element cu element și o matrice de revenire, de 768 × 2.048. În total 4,72 milioane de numere, de 32 de ori mai puține decât MLP-ul din 8B. Dar sunt 128 de experți pe strat, deci stratul stochează 604 milioane de numere de MLP, de 4 ori mai multe decât cel dens.
Routerul, pas cu pas
Routerul este cea mai mică piesă din model și cea care face toată diferența.
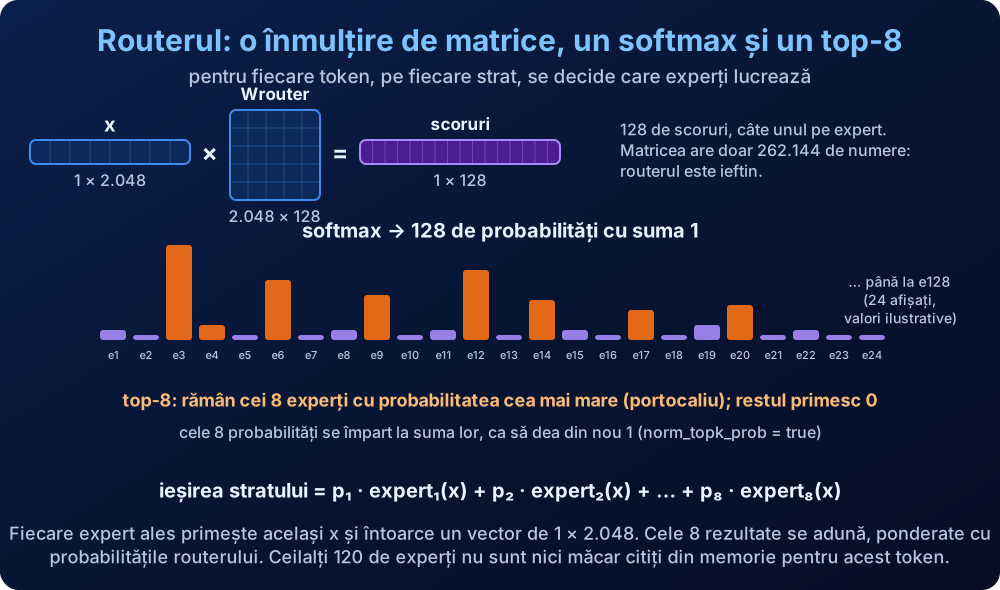
- O înmulțire de matrice. Vectorul tokenului, de 1 × 2.048, se înmulțește cu matricea routerului, de 2.048 × 128. Rezultă 128 de scoruri, câte unul pentru fiecare expert. Matricea are doar 262.144 de numere, deci pasul este aproape gratuit.
- Softmax. Scorurile devin probabilități pozitive cu suma 1, prin aceeași exponențială normalizată pe care am folosit-o la atenție.
- Top-8. Se păstrează cei 8 experți cu probabilitatea cea mai mare. Cele 8 probabilități se împart la suma lor, ca să dea din nou 1; în configurare, acest detaliu apare ca
norm_topk_prob: true. - Experții lucrează. Fiecare dintre cei 8 primește același vector x și întoarce un vector de 1 × 2.048.
- Suma ponderată. Ieșirea stratului este
p₁ · expert₁(x) + … + p₈ · expert₈(x), cu p-urile de la pasul 3. Se adună la vectorul de intrare, prin conexiunea reziduală, exact ca la stratul dens.
Pasul 3 este cel care nu există în stratul dens și care face modelul „rar” (sparse): o decizie discretă, luată separat pentru fiecare token și pentru fiecare strat.
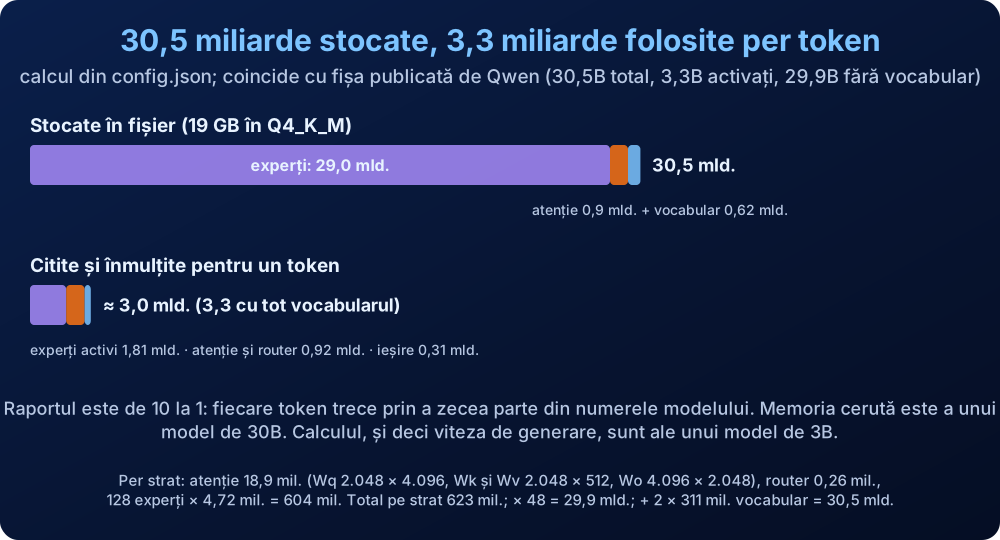
Fișa parametrilor: 30,5 miliarde stocate, 3,3 folosite
Calculul de mai jos pornește din fișierul de configurare și coincide cu cifrele publicate de Qwen: 30,5 miliarde în total, 29,9 miliarde fără vocabular, 3,3 miliarde activate.
| Matrice, per strat | Dimensiune | Numere | Per token |
|---|---|---|---|
| Wq | 2.048 × 4.096 | 8,39 milioane | toate |
| Wk | 2.048 × 512 | 1,05 milioane | toate |
| Wv | 2.048 × 512 | 1,05 milioane | toate |
| Wo | 4.096 × 2.048 | 8,39 milioane | toate |
| Router | 2.048 × 128 | 0,26 milioane | toate |
| Un expert (3 matrice) | 2.048 × 768 fiecare | 4,72 milioane | doar dacă e ales |
| 128 de experți | 604 milioane | 8 din 128: 37,7 milioane | |
| Total strat | 623 milioane | 56,9 milioane |
Înmulțit cu 48 de straturi: 29,9 miliarde stocate, 2,73 miliarde folosite per token. Cele două matrice de vocabular, de 151.936 × 2.048 fiecare, adaugă 0,62 miliarde la stocare și, la utilizare, matricea de ieșire de 0,31 miliarde, citită integral la fiecare token. Rezultă raportul de aproximativ 10 la 1 dintre ce stă în fișier și ce lucrează.
Token cu token: cine alege și ce fac experții
Alegerea experților se face pentru fiecare token în parte, pe fiecare strat în parte. Tokenul „Explică” poate folosi experții 3, 17, 29 și alți cinci pe stratul 10, iar tokenul următor cu totul alții. Pe 48 de straturi, un singur token activează 384 de experți din cei 6.144 ai modelului.
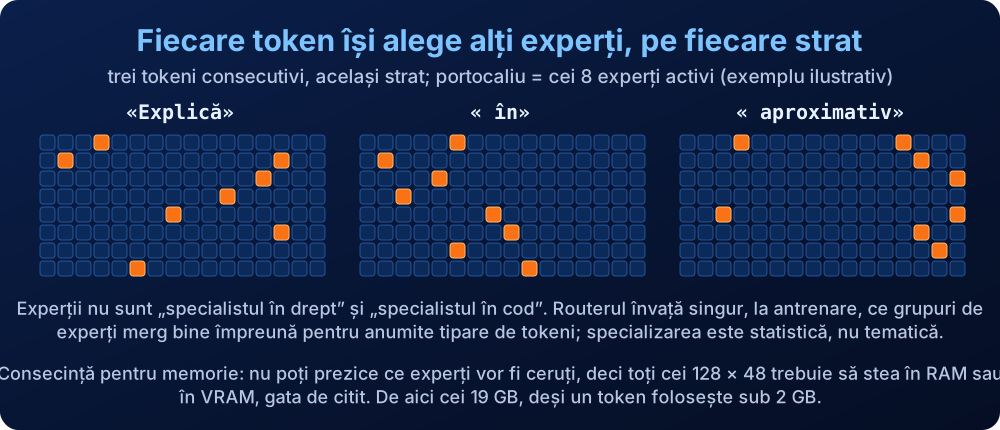
Două consecințe practice merită reținute. Prima: experții nu sunt specialiști pe domenii. Nu există „expertul în drept” și „expertul în cod”. Routerul învață la antrenare, statistic, ce grupuri de experți funcționează bine împreună pentru anumite tipare de tokeni, iar raportul Qwen3 spune doar că echilibrarea pe lot global „încurajează specializarea”, fără să o descrie tematic. A doua: pentru că nu poți ști dinainte ce experți vor fi ceruți, toți cei 6.144 trebuie să stea în memorie, gata de citit. De aici cei 19 GB.
Echilibrarea: de ce fără ea modelul se prostește
Routerul are o slăbiciune structurală. Dacă la începutul antrenării câțiva experți sunt puțin mai buni, primesc mai mulți tokeni, învață mai mult, devin și mai buni și primesc tot mai mulți tokeni. Ceilalți nu mai primesc nimic și rămân neantrenați. Modelul ajunge să folosească efectiv 3-4 experți dintr-o sută, adică se comportă ca un model mult mai mic, deși ocupă aceeași memorie.
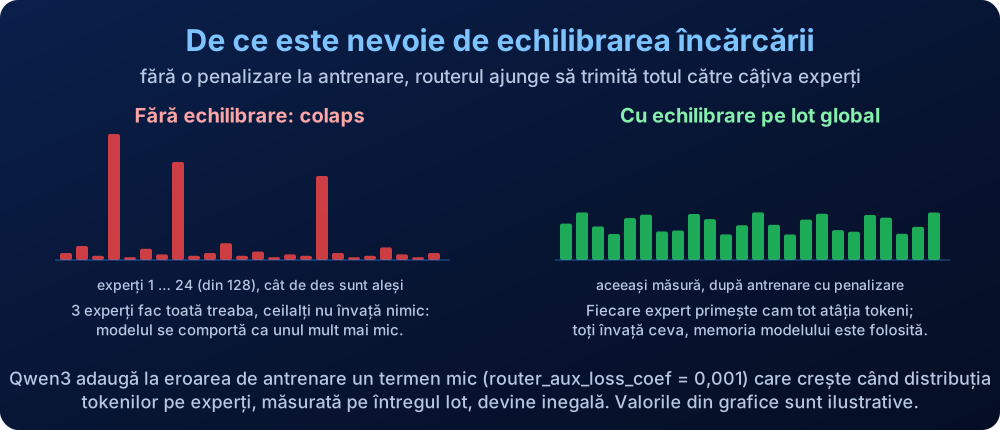
Soluția este un termen suplimentar în eroarea de antrenare, care crește când distribuția tokenilor pe experți devine inegală. Qwen3 îl aplică pe întregul lot de antrenare, nu pe fiecare secvență, cu un coeficient mic (router_aux_loss_coef: 0.001). Alte modele au ales altfel: DeepSeek-V3 folosește o strategie fără termen auxiliar, iar Mixtral se bazează pe o pierdere de echilibrare clasică. Pentru utilizator, detaliul nu se vede, dar explică de ce nu poți lua un model dens și „să-l tai” în experți după antrenare.
Cum a fost antrenat
Qwen3-30B-A3B a trecut prin aceeași pre-antrenare ca modelele dense din familie, descrisă în articolul anterior: aproximativ 36.000 de miliarde de tokeni în trei etape. Raportul tehnic afirmă că, pe aceleași date, modelele de bază MoE ajung la performanțe similare cu cele dense folosind o cincime din parametrii activați, și că 30B-A3B-Base este comparabil cu Qwen3-14B-Base și Qwen2.5-32B-Base, cu de 11 ori mai puțini parametri activați decât acesta din urmă.
Post-antrenarea este, ca la 8B, distilare „de la puternic la slab”: 30B-A3B este singurul MoE din lista modelelor obținute astfel, cu Qwen3-32B și Qwen3-235B-A22B ca profesori. În iulie 2025, Qwen a publicat două versiuni actualizate, marcate „2507”: Instruct, care nu gândește niciodată, și Thinking, care gândește întotdeauna, ambele cu context nativ de 262.144 tokeni. Modelul hibrid inițial, care comuta între cele două moduri, a rămas disponibil separat. Distincția contează mult în practică, cum vom vedea la măsurători.
Spre deosebire de Qwen2.5-MoE, Qwen3 nu are „experți partajați”, adică experți prin care trec toți tokenii; toți cei 128 sunt aleși de router.
Memorie versus calcul
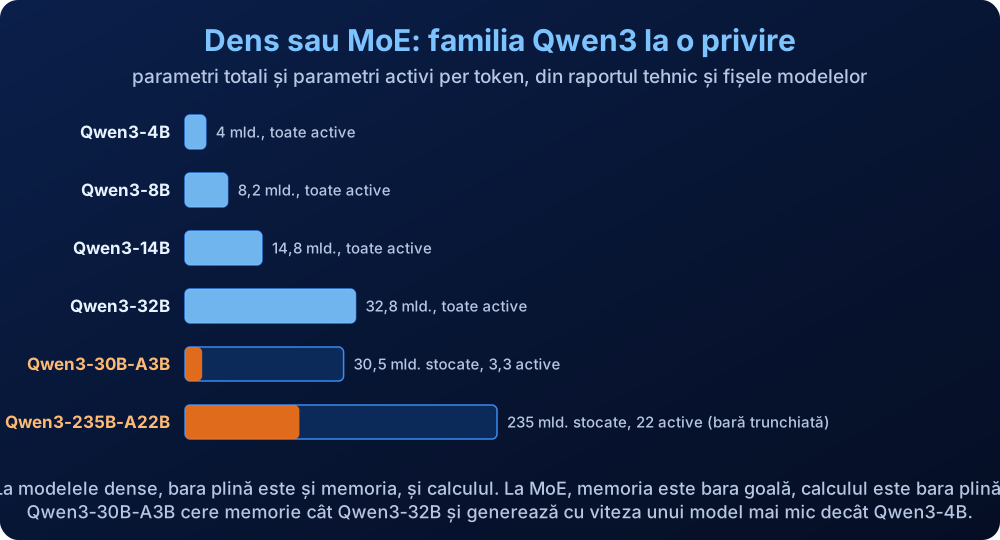
Acum putem pune cap la cap ce contează pentru un PC de birou. În articolul anterior am arătat că la generare viteza este limitată de memorie: pentru fiecare token, greutățile folosite trebuie citite din RAM sau din VRAM. La un model dens se citește tot fișierul. La un MoE se citesc doar atenția, routerele, matricea de ieșire și cei 8 experți aleși pe fiecare strat.
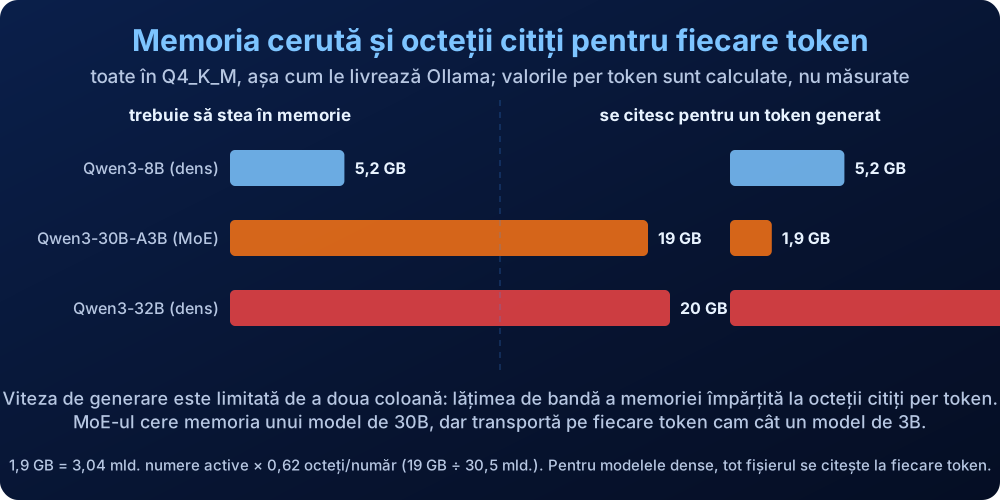
| Model, Q4_K_M | Trebuie să stea în memorie | Se citește per token | Plafon teoretic la 38,4 GB/s |
|---|---|---|---|
| Qwen3-8B (dens) | 5,2 GB | 5,2 GB | 7,4 tokeni/s |
| Qwen3-30B-A3B (MoE) | 19 GB | 1,9 GB | 20 tokeni/s |
| Qwen3-32B (dens) | 20 GB | 20 GB | 1,9 tokeni/s |
Coloana „per token” este calculată: 3,04 miliarde de numere active înmulțite cu 0,62 octeți pe număr, media din fișierul de 19 GB. Ultima coloană presupune că tot modelul stă în RAM-ul de sistem al stației noastre, cu două module DDR4-2400 în dual-channel, deci 38,4 GB/s teoretic. Pe o asemenea mașină, fără placă video, MoE-ul de 30B ar fi de aproape trei ori mai rapid decât modelul dens de 8B și de zece ori mai rapid decât cel dens de 32B. Dacă ai un singur modul de RAM, toate cifrele se înjumătățesc, cum am explicat la NUC 15 Pro.
Ce am măsurat: i5-6600K, 32 GB DDR4, RTX 3060 Ti
Stația de test este un PC de birou real, nu o configurație aleasă pentru articol: Intel i5-6600K cu 4 nuclee, 2 × 16 GB DDR4-2400, RTX 3060 Ti cu 8 GB VRAM, Windows, Ollama cu fereastra de context implicită de 4.096 tokeni. Întrebarea, aceeași de fiecare dată: „Explică în aproximativ 200 de cuvinte ce este un reverse proxy.”
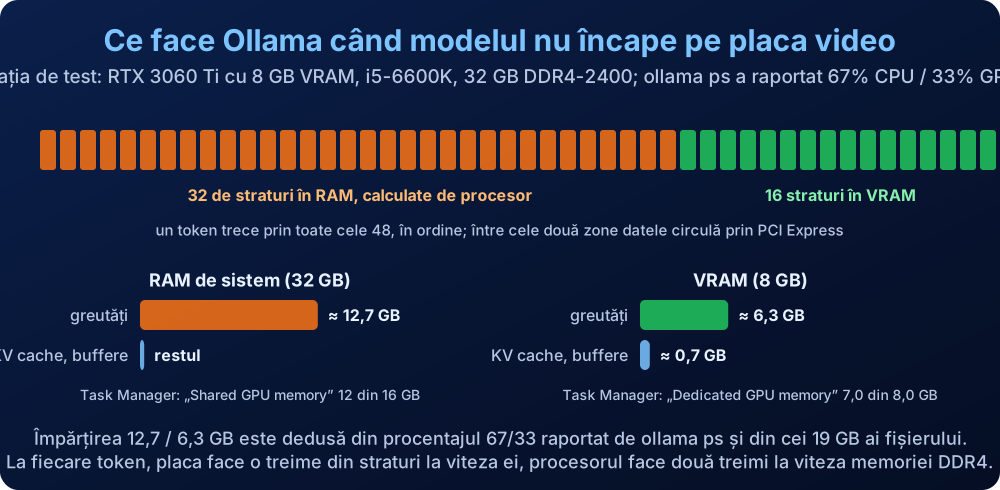
Cu 8 GB VRAM, Ollama a pus o treime din straturi pe placă și două treimi în RAM: ollama ps a raportat 67%/33% CPU/GPU, iar Task Manager arăta 7,0 din 8,0 GB memorie dedicată și 12 din 16 GB „shared GPU memory”, adică RAM de sistem folosit pentru restul modelului.
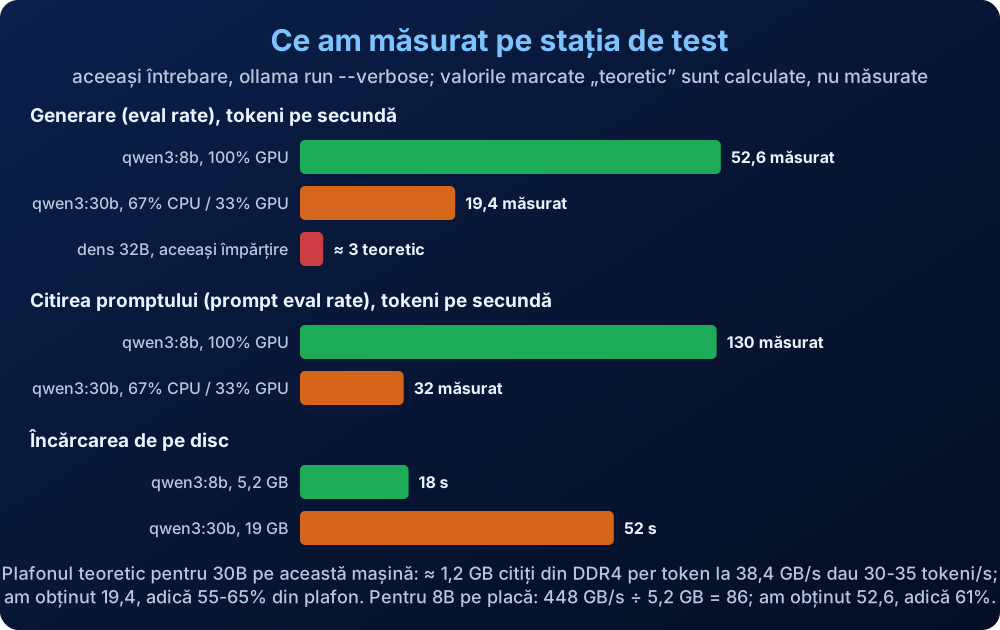
| Măsurătoare | qwen3:8b, 100% GPU | qwen3:30b, 67% CPU / 33% GPU |
|---|---|---|
| Încărcarea de pe disc | 18,1 s | 52,3 s |
| Tokeni în prompt | 36 | 30 |
| Citirea promptului | 130,2 tokeni/s | 32,4 tokeni/s |
| Tokeni generați | 275 | 2.709 |
| Generarea | 52,6 tokeni/s | 19,4 tokeni/s |
| Durata totală | 23,6 s | 3 min 13 s |
Patru observații:
- Viteza de generare confirmă calculul. Cu două treimi din straturi în RAM, un token citește din DDR4 în jur de 1,2 GB; la 38,4 GB/s, plafonul este de 30-35 tokeni/s, iar modelul a atins 19,4, adică 55-65% din el. Restul se pierde în sincronizarea dintre placă și procesor și în faptul că procesorul nu atinge lățimea de bandă teoretică. Un model dens de 32B, cu aceeași împărțire, ar fi avut plafonul la 2,9 tokeni/s. Pe 8B, integral pe placă, plafonul este 448 GB/s ÷ 5,2 GB = 86 tokeni/s, iar modelul a atins 52,6, adică 61%.
- Citirea promptului este partea slabă. Pe placă, 8B citește 130 de tokeni/s. Pe 30B, cu două treimi din straturi pe un procesor din 2015 cu 4 nuclee, doar 32. Un document de 4.000 de tokeni lipit în prompt ar aștepta două minute înainte de primul cuvânt al răspunsului. Prefill-ul este limitat de calcul, nu de memorie, iar acolo MoE-ul nu ajută atât de mult.
- Încărcarea de pe disc durează 52 de secunde pentru 19 GB. Ollama ține modelul în memorie 5 minute după ultimul răspuns; la un asistent folosit sporadic, merită mărit
keep_alive. - Cei 2.709 tokeni generați pentru un răspuns de „aproximativ 200 de cuvinte” nu sunt o eroare de măsurare. Modelul a gândit înainte să răspundă, deși rulasem cu
--think=false. Explicația este în secțiunea următoare.
Mai avem o rulare de raportat, prima pe 30B, în modul implicit. Modelul a început să gândească, a încercat să încadreze răspunsul în 200 de cuvinte, a trecut în engleză, a scos răspunsul într-un bloc \boxed{} de LaTeX, cum fac datele de antrenare pentru matematică, apoi a repetat la nesfârșit variații ale propoziției „This is the final answer. The response is complete.” A trebuit să îl oprim; nu avem statistici pentru ea. Fișa modelului avertizează despre „repetițiile fără sfârșit” și recomandă presence_penalty între 0 și 2, iar Ollama livrează qwen3 cu repeat_penalty: 1, adică fără nicio penalizare. O constrângere de lungime plus modul cu gândire au fost suficiente ca să declanșeze bucla.
Trei modele sub același nume
Ollama publică mai multe variante ale lui Qwen3-30B-A3B sub etichete diferite, iar eticheta scurtă nu spune care. Am verificat pe pagina de etichete: qwen3:30b are digestul ad815644918f, același cu qwen3:30b-a3b-thinking-2507-q4_K_M. Deci ce am rulat noi este varianta Thinking-2507, un model care, conform fișei lui, „suportă doar modul cu gândire”. De aceea --think=false nu a avut niciun efect și de aceea răspunsul a avut 2.709 tokeni.
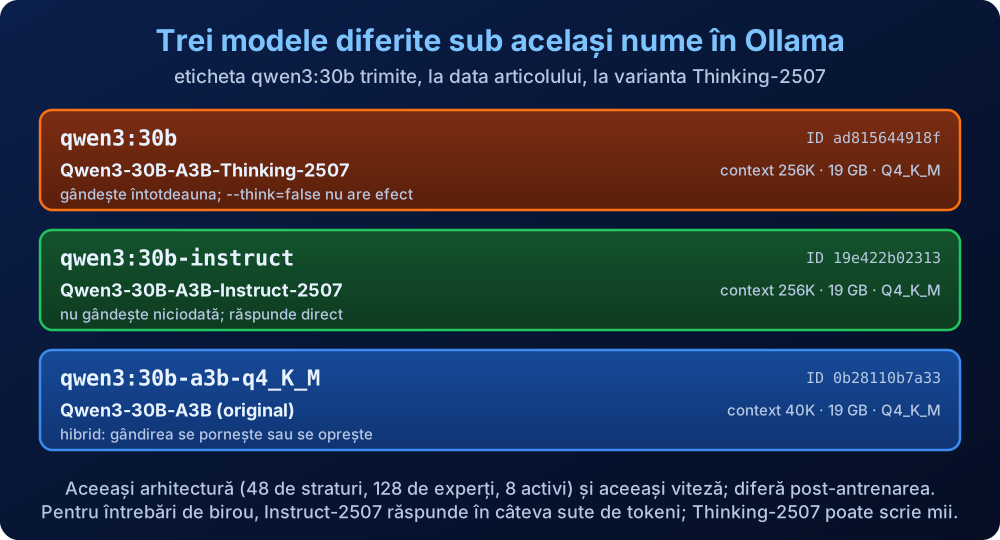
| Etichetă în Ollama | Model | Gândire | Context | Răspuns recomandat de Qwen |
|---|---|---|---|---|
qwen3:30b |
Thinking-2507 | întotdeauna | 256K | până la 32.768 tokeni |
qwen3:30b-instruct |
Instruct-2507 | niciodată | 256K | până la 16.384 tokeni |
qwen3:30b-a3b-q4_K_M |
hibridul original | comutabilă | 40K | 32.768 cu gândire |
Pentru un asistent de birou, care rezumă e-mailuri, răspunde din documente sau completează formulare, varianta Instruct este alegerea firească: răspunde direct, în câteva sute de tokeni, cu temperatura 0,7 recomandată de Qwen. Varianta Thinking este pentru probleme în care merită să aștepți minute pentru un răspuns mai bun. Etichetele se pot schimba în timp, deci verificarea digestului rămâne singura metodă sigură.
Cum verifici pe calculatorul tău
- Rulează
ollama pull qwen3:30b-instructdacă vrei varianta fără gândire, sauollama pull qwen3:30bpentru cea cu gândire. Fiecare descarcă 19 GB. - Rulează
ollama show qwen3:30b-instruct. SecțiuneaModelarată arhitecturaqwen3moe, parametrii30.5B, cuantizareaQ4_K_Mși lungimea contextului. - Pune o întrebare cu
ollama run qwen3:30b-instruct --verboseși citeșteprompt eval rateșieval ratede la final. Prima rulare include încălzirea; a doua, cu modelul deja încărcat, dă cifrele reale. - Într-un al doilea terminal, în maximum 5 minute,
ollama psarată coloanaPROCESSOR:100% GPU,100% CPUsau procentajul împărțirii. Cu 8 GB VRAM te aștepți la aproximativ o treime pe placă; cu 16 GB, la două treimi; cu 24 GB, modelul încape integral. - Dacă răspunsurile intră în repetiție, setează
/set parameter presence_penalty 1.5în sesiune saupresence_penaltyîn opțiunile API, cum recomandă Qwen, și verifică din nou. - Pentru documente lungi, mărește fereastra cu
/set parameter num_ctx 16384. KV cache-ul acestui model este mic, 96 KB pe token, datorită celor 4 capete de chei-valori: 16.384 tokeni înseamnă aproximativ 1,5 GB în plus.
Unde nu se potrivește
- Sub 32 GB de RAM. Fișierul de 19 GB plus KV cache, buffere și sistemul de operare nu încap în 16 GB. Un laptop cu 16 GB rulează 8B, nu 30B-A3B, oricât de rapid ar fi MoE-ul pe hârtie.
- Calitatea per răspuns nu este a unui model dens de 32B. Raportul Qwen3 compară 30B-A3B-Base cu Qwen3-14B-Base, nu cu 32B. Pentru raționament dificil, un model dens de 32B pe o placă cu 24 GB rămâne mai bun, dar de zece ori mai lent pe o mașină ca a noastră.
- Procesoare vechi sau puține nuclee. Prefill-ul de 32 tokeni/s pe i5-6600K face documentele lungi greu de folosit. MoE-ul ajută la generare, nu la citirea promptului.
- Modul cu gândire, pe sarcini simple. Mii de tokeni de raționament pentru un răspuns de 200 de cuvinte înseamnă minute de așteptare și, cum am văzut, risc de buclă. Pentru asistentul de birou, varianta Instruct.
- Mai mulți utilizatori simultan. Cu cereri paralele, fiecare token din fiecare cerere activează alți experți, iar avantajul de memorie se diluează; serverele cu mulți utilizatori au nevoie de alte optimizări decât un PC cu un singur om în fața lui.
Cum procedăm noi
În Brio Argus, asistentul AI conectat la documentele interne ale firmei, modelele locale rulează prin Ollama, iar platforma are un benchmark între modele exact pentru decizia de mai sus: pe hardware-ul existent al clientului, care model dă răspunsuri suficient de bune, suficient de repede. La clienții cu 32 GB de RAM și o placă video modestă, un MoE de clasa 30B-A3B în varianta Instruct este candidatul implicit pentru documentele marcate on-premise, care nu pot pleca la un furnizor cloud. Sub 32 GB rămânem la 8B sau propunem un upgrade de memorie, care costă mai puțin decât o placă video.
Măsurătorile de mai sus le repetăm pe mașina clientului înainte de orice recomandare, cu documentele lui, pentru că prefill-ul pe un procesor vechi poate anula avantajul de viteză la generare.
Dacă vrei un asistent AI pe documentele firmei și ai un PC cu 32 GB de RAM, scrie-ne configurația lui. Îți spunem în câteva minute dacă un model MoE de 30B rulează acceptabil pe el și ce ai câștiga dintr-un upgrade de memorie față de o placă video.
Întrebări frecvente
Ce înseamnă A3B în numele modelului?
„A3B” înseamnă „3 miliarde activate”: din cele 30,5 miliarde de parametri ai lui Qwen3-30B-A3B, fiecare token folosește aproximativ 3,3 miliarde. Pe fiecare dintre cele 48 de straturi, un router alege 8 experți din 128, iar numai aceștia calculează. Memoria cerută este a unui model de 30B, viteza de generare este a unui model de 3B.
Îmi trebuie placă video ca să rulez Qwen3-30B-A3B?
Nu neapărat. Modelul rulează și integral pe procesor, dacă ai cel puțin 32 GB de RAM, iar viteza de generare este limitată de lățimea de bandă a memoriei: cu două module DDR4-2400 plafonul teoretic este de 20 de tokeni pe secundă. Placa video accelerează citirea promptului și partea de straturi care încape în VRAM; cu 8 GB VRAM am măsurat 19,4 tokeni pe secundă, cu o treime din model pe placă.
Este un model MoE mai bun decât unul dens de aceeași mărime?
Nu, la aceeași mărime stocată. Raportul Qwen3 compară 30B-A3B cu modelele dense de 14B, nu cu cel de 32B, deci calitatea per răspuns este a unui model mediu. Avantajul MoE este că obții acea calitate cu viteza unui model mic, pe o mașină care are RAM dar nu are o placă video de 24 GB.
De ce a intrat modelul într-o buclă de repetiție?
Am rulat varianta cu gândire cu o constrângere de lungime, iar modelul a repetat la nesfârșit „This is the final answer” după ce scrisese răspunsul. Fișa modelului avertizează despre repetiții și recomandă presence_penalty între 0 și 2, pe care Ollama nu îl setează implicit. Pentru întrebări de birou, varianta qwen3:30b-instruct, fără gândire, evită problema.
Merge pe un laptop cu 16 GB de RAM?
Nu în Q4_K_M, pentru că fișierul are 19 GB și toți experții trebuie să stea în memorie, chiar dacă fiecare token folosește doar 8 din 128. Pe 16 GB rămâi la Qwen3-8B, de 5,2 GB, sau la gpt-oss-20b, un MoE de 21 de miliarde de parametri cu 3,6 miliarde activi, pe care OpenAI îl livrează cuantizat MXFP4 pentru a rula în 16 GB.