
Radiografia unui LLM: cum învață și cum răspunde Qwen3-8B din Ollama
Ce este, concret, un model de limbaj instalat local: cum a fost antrenat Qwen3-8B, ce matrice are în interior și ce se întâmplă de la întrebare la răspuns.
Pe scurt
Un LLM instalat în Ollama este un fișier de câțiva gigaocteți cu numere (greutăți) organizate în matrice, plus un program care le înmulțește într-o ordine fixă. Qwen3-8B a fost antrenat pe aproximativ 36.000 de miliarde de tokeni să prezică următoarea bucată de text, apoi distilat din modele mai mari. La utilizare, întrebarea devine o listă de numere, trece prin 36 de straturi identice de înmulțiri de matrice și iese, token cu token, ca distribuție de probabilități din care se alege răspunsul.
Instalezi Ollama, scrii ollama run qwen3:8b, pui o întrebare și primești un răspuns coerent în română. Fără internet, fără abonament, de pe un laptop obișnuit. Întrebarea firească este: ce s-a întâmplat, de fapt, între Enter și primul cuvânt afișat?
Răspunsul scurt: un model de limbaj este un fișier cu miliarde de numere, organizate în matrice, plus un program care le înmulțește într-o ordine fixă. Nimic din el nu caută pe internet și nu „înțelege” în sensul uman. Totul este aritmetică: înmulțiri de matrice, adunări, câteva funcții simple, repetate pentru fiecare cuvânt generat.
Articolul face radiografia unui asemenea model, pe exemplul Qwen3-8B, publicat de Alibaba sub licență Apache 2.0 și unul dintre cele mai descărcate modele din biblioteca Ollama. L-am ales pentru că este documentat complet: raport tehnic, fișier de configurare public și tokenizator descărcabil, deci fiecare cifră de mai jos poate fi verificată. Prima parte explică cum a fost antrenat. A doua urmărește drumul unei întrebări prin rețea, cu dimensiunile exacte ale matricelor. Matematica necesară este cea de liceu: înmulțire de matrice, transpunere, exponențială.
Ce este, fizic, un model instalat în Ollama
Când rulezi ollama pull qwen3:8b, se descarcă un fișier în format GGUF de 5,2 GB, plus câteva fișiere mici: șablonul de conversație, parametrii impliciți și licența. Fișierul mare conține greutățile modelului, adică numerele. Ollama este un server local, pe portul 11434, care încarcă acest fișier în memorie și răspunde la cereri prin motorul de inferență llama.cpp. Terminalul ollama run, aplicațiile de chat și propriile tale programe sunt toate clienți ai aceluiași server.
| Caracteristică | Qwen3-8B |
|---|---|
| Parametri (numere) | 8,19 miliarde: 6,95 miliarde în straturi, 1,24 miliarde în cele două matrice de vocabular |
| Straturi | 36 |
| Dimensiunea vectorului intern | 4.096 |
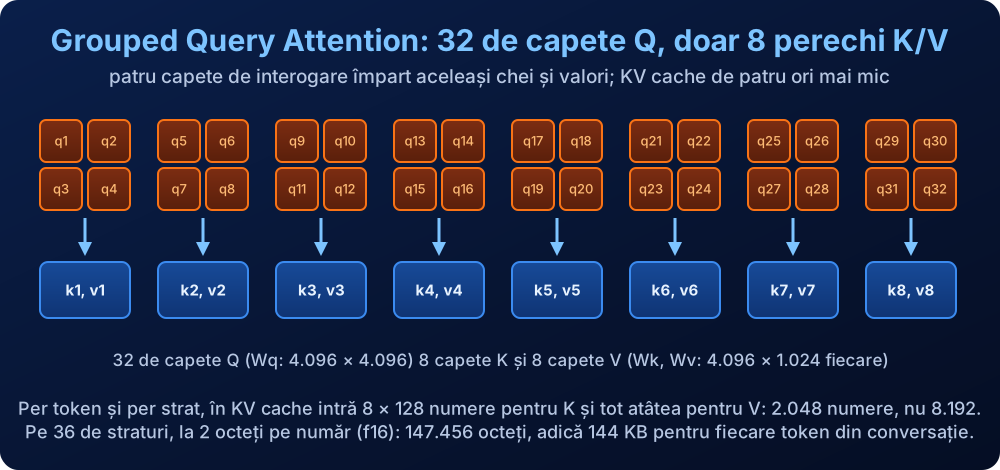
| Capete de atenție | 32 pentru interogări, 8 pentru chei și valori |
| Dimensiunea unui cap | 128 |
| Dimensiunea internă a MLP | 12.288 |
| Vocabular | 151.669 tokeni (matrice de 151.936 rânduri) |
| Context | 32.768 tokeni nativ, 131.072 cu YaRN |
| Precizia originală | bfloat16, 16 biți pe număr |
| Fișierul din Ollama | GGUF, cuantizat Q4_K_M, 5,2 GB |
Sursele: config.json și fișa modelului de pe Hugging Face, pagina qwen3:8b din biblioteca Ollama. Un „parametru” sau o „greutate” este un singur număr din aceste matrice. Nu este o regulă, nu este un cuvânt, nu este un fapt stocat. Este un coeficient într-o înmulțire.
Pre-antrenarea: un singur joc, jucat de 36.000 de miliarde de ori
Antrenarea unui model de limbaj este, în esență, un singur exercițiu repetat la nesfârșit: primește un fragment de text și ghicește următorul token. Un token este o bucată de text, de obicei un cuvânt sau o parte de cuvânt, despre care vorbim mai jos. Modelul nu primește reguli gramaticale, nu primește definiții, nu primește fapte etichetate. Primește text și este penalizat de fiecare dată când ghicește prost.
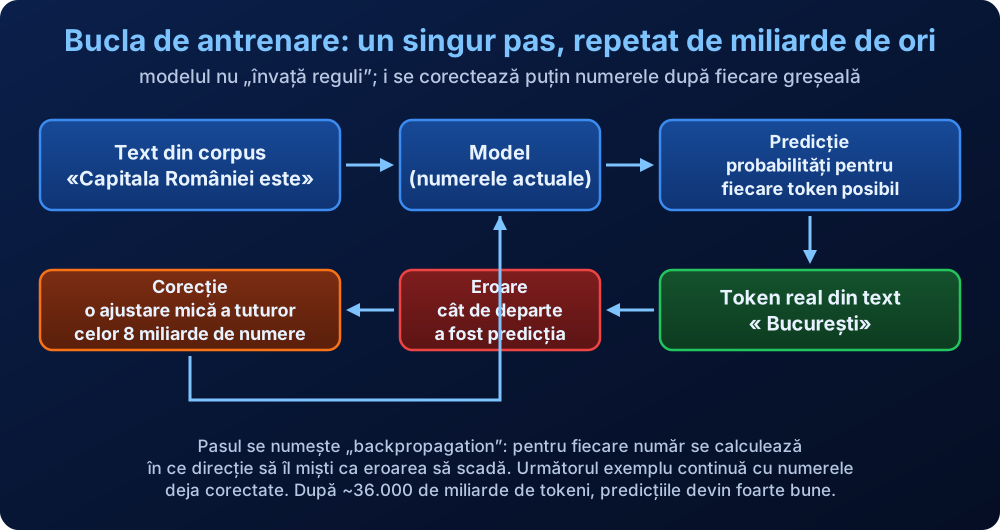
Pasul se desfășoară așa. Modelul, cu numerele pe care le are în acel moment, calculează o probabilitate pentru fiecare token din vocabular. Textul real spune care era tokenul corect. Diferența dintre ce a prezis și ce trebuia devine un număr numit eroare. Apoi, printr-un procedeu numit backpropagation, se calculează pentru fiecare dintre cele 8 miliarde de numere în ce direcție trebuie mișcat, cu foarte puțin, ca eroarea să scadă. Următorul fragment de text continuă cu numerele deja corectate.
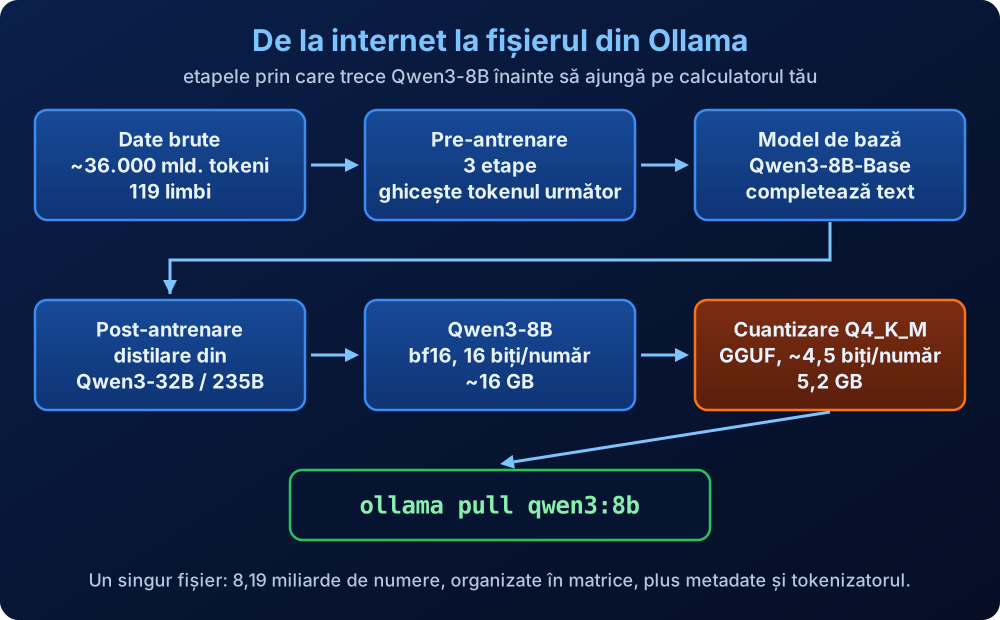
Qwen3 a trecut prin acest ciclu pe aproximativ 36.000 de miliarde de tokeni, în 119 limbi și dialecte, în trei etape descrise în raportul tehnic:
| Etapă | Tokeni | Lungimea unui fragment | Scop |
|---|---|---|---|
| S1, generală | peste 30.000 de miliarde | 4.096 tokeni | limbă, cunoștințe generale |
| S2, raționament | aproximativ 5.000 de miliarde | 4.096 tokeni | STEM, cod, raționament, date sintetice |
| S3, context lung | sute de miliarde | 32.768 tokeni | documente lungi |
Datele vin din text web, din documente de tip PDF din care textul a fost extras cu Qwen2.5-VL, și din date sintetice de matematică și cod generate cu modelele Qwen2.5-Math și Qwen2.5-Coder. În etapa a treia, parametrul care codifică poziția tokenilor (baza RoPE) a fost ridicat de la 10.000 la 1.000.000, ca modelul să poată urmări fragmente de 32.768 tokeni. Raportul tehnic nu detaliază costul în ore GPU al pre-antrenării.
Rezultatul se numește Qwen3-8B-Base. Știe să continue orice text, în orice stil, dar nu este un asistent. Dacă îi dai o întrebare, poate la fel de bine să continue cu o altă întrebare, pentru că așa arată multe pagini de pe internet.
Post-antrenarea: de la „completează textul” la „răspunde la întrebare”
A doua fază îl transformă pe cel care completează text într-un asistent care răspunde, urmează instrucțiuni și poate „gândi” înainte să răspundă. Pentru modelele mari din familie, Qwen3-235B-A22B și Qwen3-32B, raportul descrie patru etape: antrenare pe lanțuri lungi de raționament scrise de oameni și filtrate, învățare prin recompense pe probleme de matematică și cod cu răspuns verificabil, „fuziunea” modului cu gândire și a celui fără, apoi o ultimă rundă de învățare prin recompense pentru sarcini generale.
Qwen3-8B nu a trecut prin aceste patru etape. Modelele mici din familie, de la 0,6B la 14B, au fost obținute prin distilare „de la puternic la slab”: modelul mare joacă rolul profesorului, cel mic rolul elevului.
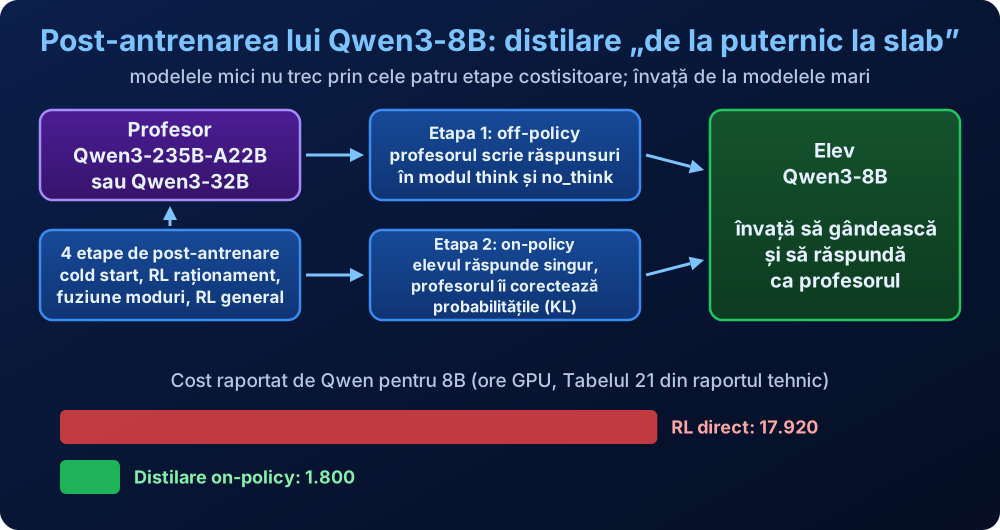
Distilarea are două etape. În prima, profesorul scrie răspunsuri, cu și fără lanț de gândire, iar elevul este antrenat să le reproducă. În a doua, elevul răspunde singur, iar pentru fiecare token probabilitățile lui sunt trase spre cele ale profesorului. Raportul compară costul pentru un model de 8B, în ore GPU:
| Metodă | Ore GPU | Rezultat |
|---|---|---|
| Învățare prin recompense, direct pe modelul mic | 17.920 | mai slab |
| Distilare on-policy din modelul mare | 1.800 | mai bun |
De aici vine și comportamentul pe care îl vezi în Ollama: Qwen3 scrie mai întâi un bloc între etichetele <think> și </think>, apoi răspunsul. Blocul de gândire este text generat token cu token, exact ca restul, și poate fi dezactivat cu /no_think în mesaj, cu /set nothink în terminalul Ollama sau cu parametrul think: false în API.
Cuantizarea: cum încape un model de 16 GB în 5,2 GB
Qwen publică modelul în bfloat16, un format cu 16 biți pe număr. Cele 8,19 miliarde de numere ocupă astfel aproximativ 16,4 GB, mai mult decât RAM-ul multor laptopuri și mult mai mult decât memoria unei plăci video obișnuite. Fișierul din Ollama are 5,2 GB, pentru că este cuantizat.
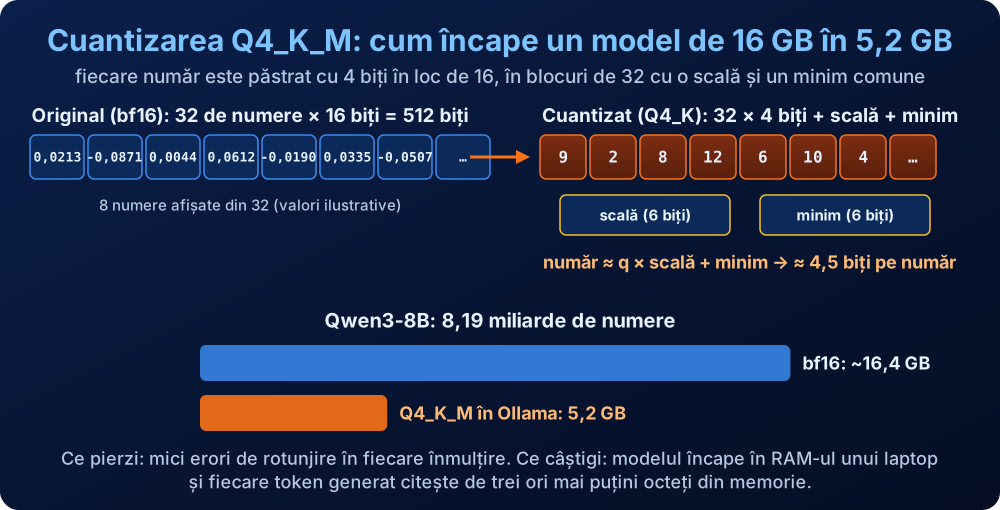
Cuantizarea Q4_K_M grupează greutățile în blocuri de 32. Pentru fiecare bloc se rețin o scală și un minim, iar fiecare număr din bloc devine un întreg de la 0 la 15, pe 4 biți. La utilizare, numărul se reconstruiește ca q × scală + minim. Cu tot cu scale și minime, rezultă aproximativ 4,5 biți pe greutate în loc de 16. Sufixul „M” înseamnă că anumite matrice mai sensibile sunt păstrate la o precizie puțin mai mare, de unde și cei 5,2 GB în loc de 4,6.
Ce pierzi: fiecare înmulțire folosește un număr rotunjit, deci apar mici erori care se adună pe cele 36 de straturi. Pentru majoritatea sarcinilor diferența față de modelul original este mică. Ce câștigi: modelul încape în memoria unui laptop și, cum vom vedea la final, generează text de aproape trei ori mai repede pe aceeași mașină.
Partea a doua: drumul unei întrebări prin Ollama
De aici urmărim ce se întâmplă când scrii „Ce este un LLM?” și apeși Enter.
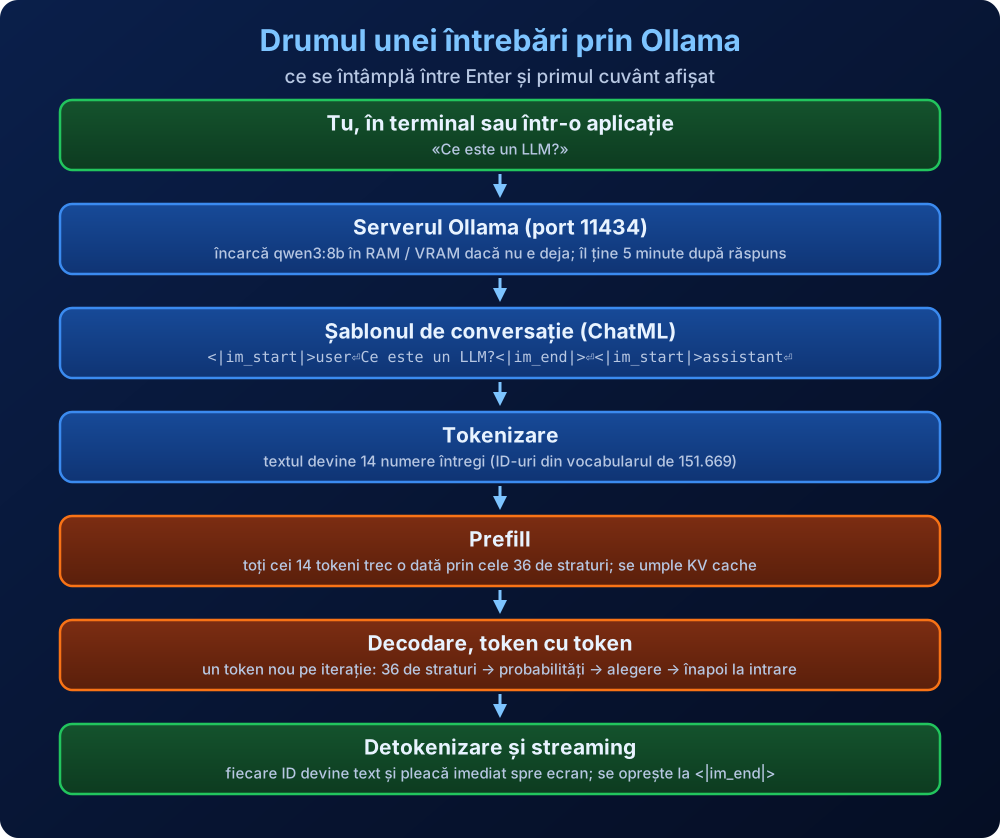
- Clientul trimite cererea serverului.
ollama runeste doar un client: trimite mesajul lahttp://localhost:11434/api/chat, împreună cu istoricul conversației. O aplicație de chat sau un program propriu face exact același lucru. - Serverul încarcă modelul. La prima cerere, cei 5,2 GB se citesc de pe disc în RAM sau în memoria plăcii video, ceea ce durează câteva secunde. Modelul rămâne încărcat 5 minute după ultimul răspuns, ca următoarea întrebare să nu plătească din nou încărcarea.
- Mesajele se pun în șablon. Modelul nu primește „întrebare” și „răspuns” ca noțiuni. Primește un singur text, construit după formatul ChatML pe care l-a văzut la antrenare, cu tokeni speciali care marchează cine vorbește:
<|im_start|>user
Ce este un LLM?<|im_end|>
<|im_start|>assistant
Textul se termină cu rândul assistant gol: modelul trebuie să continue de acolo. Qwen3 nu are un mesaj de sistem implicit, iar modul cu gândire este pornit implicit.
- Tokenizarea. Textul este tăiat în bucăți din vocabular și fiecare bucată devine un număr întreg. Pentru șablonul de mai sus rezultă 14 tokeni. Detaliile, mai jos.
- Prefill. Toți cei 14 tokeni trec deodată prin cele 36 de straturi. Pentru fiecare token și fiecare strat se calculează și se păstrează două vectori, cheia și valoarea, în ceea ce se numește KV cache.
- Decodarea. Din ieșirea ultimului token se alege tokenul următor. Acesta se lipește la sfârșitul textului, trece singur prin cele 36 de straturi, folosind KV cache pentru tot ce a fost înainte, și produce următorul token. Bucla se repetă.
- Detokenizarea și streaming-ul. Fiecare ID ales devine text și pleacă imediat spre client, de aceea răspunsul „se scrie” sub ochii tăi. Bucla se oprește când modelul alege tokenul
<|im_end|>, configurat în Ollama ca semnal de oprire, sau la limita de lungime.
Răspunsul API-ului conține și contabilitatea acestor pași: prompt_eval_count (câți tokeni avea promptul), eval_count (câți tokeni a generat), plus duratele fiecărei etape în nanosecunde. Aceleași cifre le afișează ollama run cu opțiunea --verbose.
Tokenizarea: ce vede modelul în loc de litere
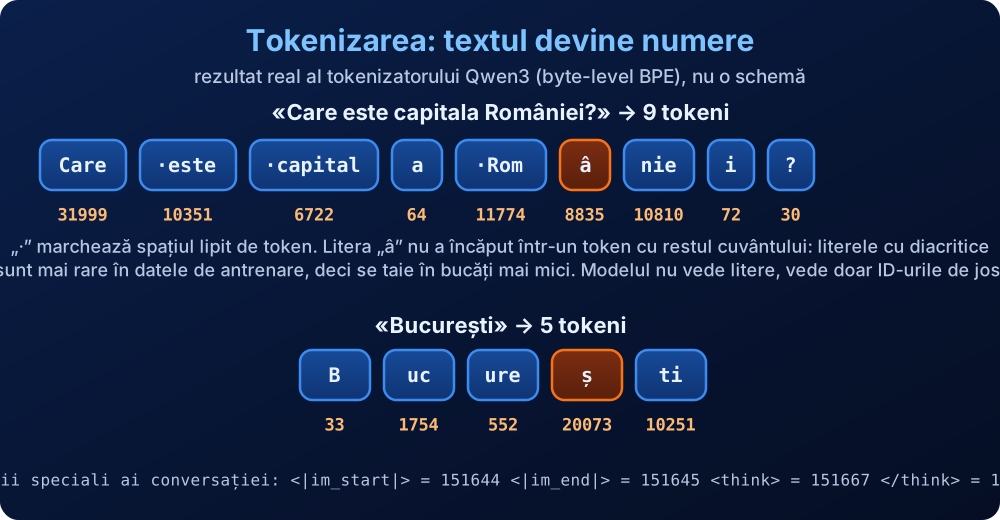
Vocabularul Qwen3 are 151.669 de tokeni, construiți prin byte-level BPE: secvențele de octeți care apar frecvent în datele de antrenare au devenit tokeni, cele rare se descompun în bucăți mai mici, la limită în octeți individuali. De aceea niciun text nu este „necunoscut”. Am rulat tokenizatorul oficial pe o propoziție în română:
| Text | Tokeni | Observație |
|---|---|---|
| „Care este capitala României?” | 9 | „capitala” se rupe în „capital” + „a”; „României” în patru bucăți |
| „București” | 5 | „ș” este token separat |
| „Ce este un LLM?” | 6 | „LLM” devine „L” + „LM” |
| șablonul complet al întrebării | 14 | cu <|im_start|>, user, assistant și rândurile noi |
Literele cu diacritice sunt tokeni separați pentru că româna este o limbă rară în datele de antrenare. Consecința practică: un text în română costă mai mulți tokeni decât același text în engleză, deci ocupă mai mult din fereastra de context și se generează mai încet. Din acest moment, modelul nu mai vede litere. Vede numai ID-urile: 31999, 10351, 6722 și așa mai departe.
Fișa matricelor: ce stă în cele 36 de straturi
Înainte de a urmări un token prin rețea, iată inventarul complet al matricelor, calculat de noi din config.json. Totalul coincide cu cifrele publicate de Qwen (6,95 miliarde fără vocabular) și de Ollama (8,19 miliarde).
| Matrice | Dimensiune (rânduri × coloane) | Numere | Rol |
|---|---|---|---|
| Embedding | 151.936 × 4.096 | 622,3 milioane | ID → vector; o singură dată, la intrare |
| Wq | 4.096 × 4.096 | 16,8 milioane | interogările, 32 de capete × 128 |
| Wk | 4.096 × 1.024 | 4,2 milioane | cheile, 8 capete × 128 |
| Wv | 4.096 × 1.024 | 4,2 milioane | valorile, 8 capete × 128 |
| Wo | 4.096 × 4.096 | 16,8 milioane | recombină cele 32 de capete |
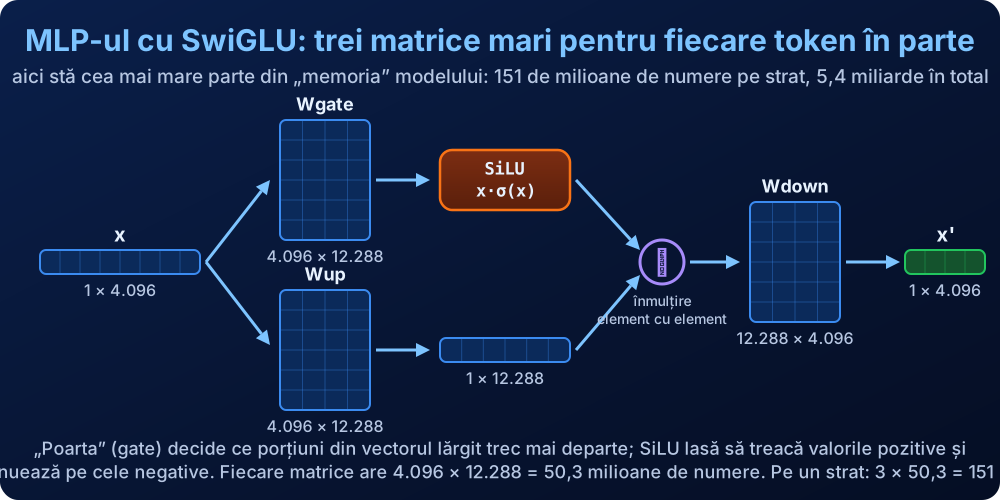
| Wgate | 4.096 × 12.288 | 50,3 milioane | MLP, „poarta” |
| Wup | 4.096 × 12.288 | 50,3 milioane | MLP, lărgire |
| Wdown | 12.288 × 4.096 | 50,3 milioane | MLP, revenire la 4.096 |
| Vectori RMSNorm | 2 × 4.096 + 2 × 128 | 8.448 | scalare, inclusiv QK-Norm |
| Matricea de ieșire | 4.096 × 151.936 | 622,3 milioane | vector → scor per token; o singură dată, la ieșire |
Un strat conține Wq, Wk, Wv, Wo, Wgate, Wup, Wdown și vectorii de normalizare: 192,9 milioane de numere. Înmulțit cu 36 de straturi dă 6,945 miliarde. Embedding-ul și matricea de ieșire, care la Qwen3-8B sunt separate, adaugă 1,245 miliarde. Totalul este 8,19 miliarde.
Toate operațiile de mai jos sunt înmulțiri între un vector linie și o matrice. Dacă x are 1 rând și 4.096 coloane, iar W are 4.096 rânduri și 4.096 coloane, atunci x × W are din nou 1 rând și 4.096 coloane. Fiecare număr din rezultat este suma produselor dintre cele 4.096 numere din x și o coloană din W. Asta este tot. Restul articolului aplică această regulă de câteva sute de ori.
Un token, pas cu pas, prin primul strat
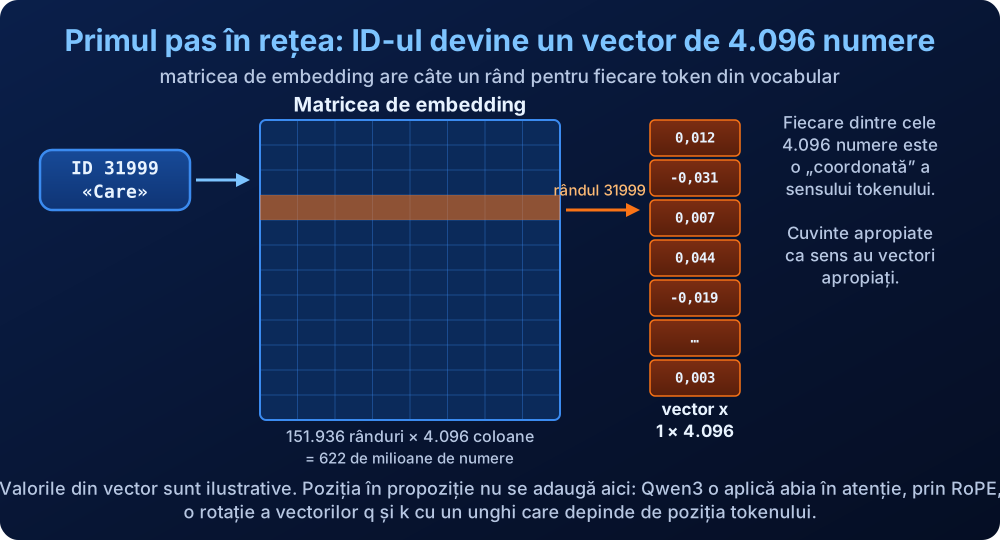
Urmărim tokenul „Care” (ID 31999) prin stratul 1. Fiecare strat următor face exact aceleași operații, cu propriile matrice.
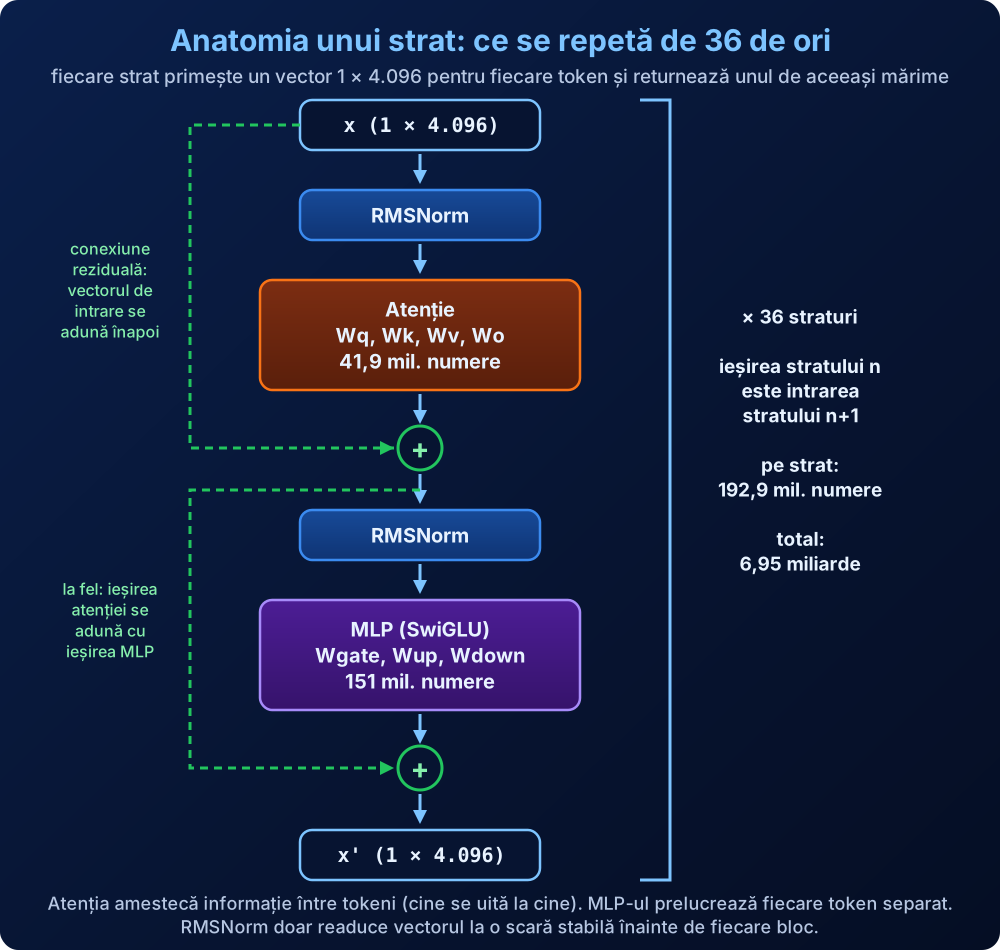
- Embedding. Rândul 31999 din matricea de embedding devine vectorul
x, de 1 × 4.096. Fiecare dintre cele 4.096 numere este o „coordonată” a sensului tokenului, învățată la antrenare. Tokeni cu sensuri apropiate au vectori apropiați. - RMSNorm. Vectorul se împarte la rădăcina mediei pătratelor elementelor sale și se înmulțește, element cu element, cu un vector învățat de 4.096 numere. Scopul este doar să țină valorile într-o plajă stabilă înainte de fiecare bloc.
- Interogări, chei, valori. Trei înmulțiri:
x × Wqdă un vector de 1 × 4.096, care se taie în 32 de bucăți de câte 128, una pentru fiecare cap de atenție.x × Wkșix × Wvdau câte un vector de 1 × 1.024, adică 8 capete de câte 128. Qwen3 normalizează apoi fiecare bucată q și k (QK-Norm), o stabilizare introdusă în această generație. - Poziția, prin RoPE. Până aici, modelul nu știe că „Care” este primul cuvânt. RoPE rotește perechile de coordonate din q și k cu un unghi proporțional cu poziția tokenului. Efectul: produsul scalar dintre un q și un k depinde de distanța dintre cei doi tokeni, nu doar de conținutul lor.
- Scorurile de atenție. Pentru fiecare cap, vectorul q (1 × 128) se înmulțește cu transpusa matricei K, care conține cheile tuturor tokenilor de până acum, câte una pe rând. K are n rânduri și 128 de coloane; transpusa are 128 de rânduri și n coloane; rezultatul este un rând de n scoruri, împărțit la √128 ca valorile să nu explodeze. Tokenii de după cel curent nu există încă în text, deci nu participă: aceasta este „atenția cauzală”.
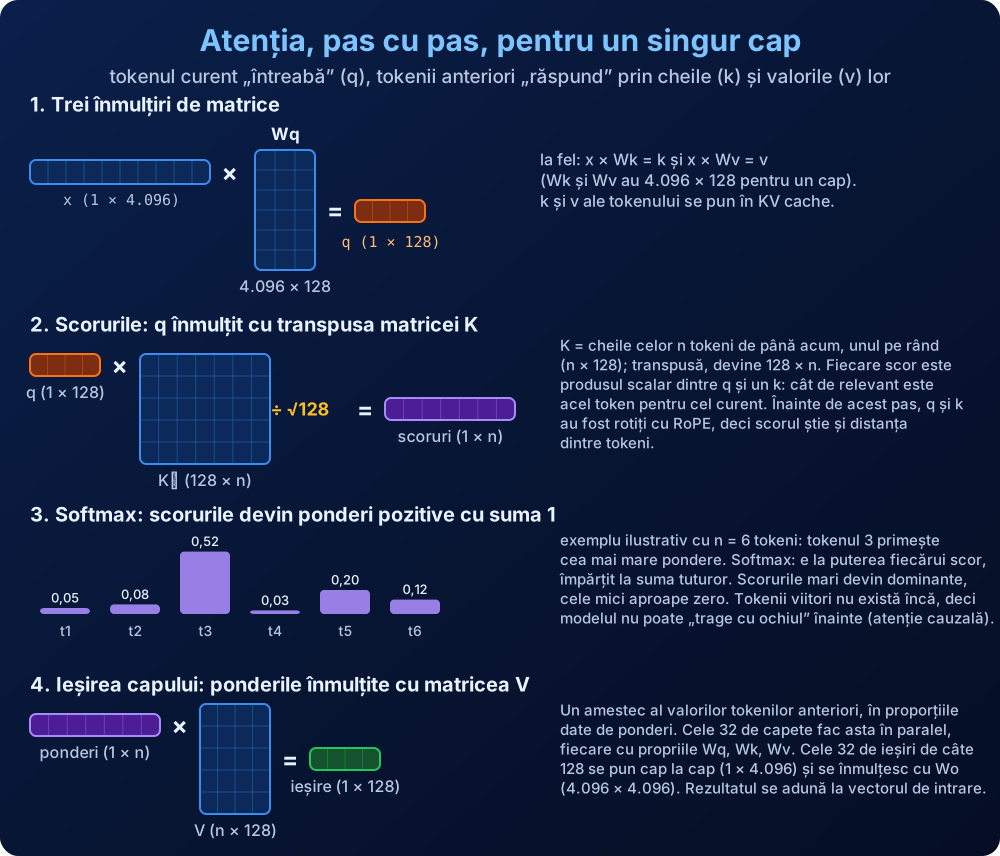
- Softmax. Scorurile devin ponderi pozitive cu suma 1: fiecare scor se ridică la exponențială și se împarte la suma tuturor exponențialelor. Scorurile mari devin dominante, cele mici se duc spre zero. Rezultatul spune, pentru tokenul curent, cât de mult „se uită” la fiecare dintre tokenii anteriori.
- Amestecul valorilor. Rândul de ponderi (1 × n) se înmulțește cu matricea V (n × 128), care conține valorile tokenilor anteriori. Rezultatul, 1 × 128, este o medie ponderată a acestora. Cele 32 de rezultate ale capetelor se pun cap la cap într-un vector de 1 × 4.096, care se înmulțește cu Wo.
- Conexiunea reziduală. Ieșirea atenției se adună la vectorul
xde la pasul 1. Fără această adunare, informația inițială s-ar dilua după câteva straturi; cu ea, fiecare strat doar corectează și îmbogățește ce avea deja.
- MLP cu SwiGLU. După o nouă RMSNorm, vectorul trece prin cele trei matrice mari.
x × Wgateșix × Wupdau fiecare un vector de 1 × 12.288. Primul trece prin funcția SiLU, care lasă valorile pozitive aproape neschimbate și le atenuează puternic pe cele negative, apoi se înmulțește element cu element cu al doilea. Rezultatul, tot 1 × 12.288, se înmulțește cu Wdown și revine la 1 × 4.096. Se adună din nou la vectorul de dinainte.
- Următorul strat. Vectorul rezultat, tot 1 × 4.096, este intrarea stratului 2. După 36 de straturi, vectorul tokenului curent conține tot ce a extras modelul din întreaga conversație pentru a prezice ce urmează.
Diferența dintre cele două blocuri merită reținută. Atenția este singurul loc în care tokenii schimbă informație între ei. MLP-ul lucrează pe fiecare token separat și este, în practică, locul unde stau asocierile învățate: că după „capitala României” urmează cel mai probabil „București”, că un anumit API se apelează într-un anumit fel.
Câte operații înseamnă asta? Fiecare înmulțire vector × matrice costă aproximativ două operații elementare pentru fiecare număr din matrice. Pentru un token, prin toate cele 36 de straturi și matricea de ieșire, rezultă în jur de 16 miliarde de înmulțiri și adunări. Un răspuns de 500 de tokeni înseamnă 8.000 de miliarde de operații. Cifra este teoretică, dar explică de ce un laptop se încălzește.
Memoria conversației: KV cache
Pasul 5 de mai sus înmulțea q cu cheile tuturor tokenilor anteriori. Dacă acele chei s-ar recalcula la fiecare token nou, costul ar crește cu pătratul lungimii conversației. În schimb, cheile și valorile fiecărui token, pe fiecare strat, se calculează o singură dată și se păstrează în memorie.
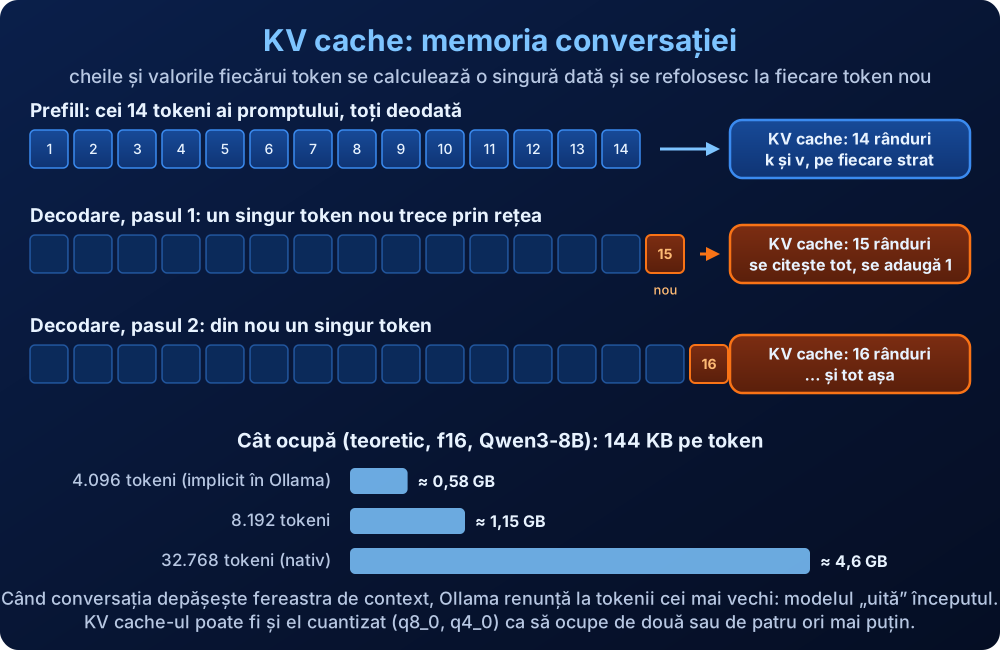
Cât ocupă se calculează direct din arhitectură: 36 de straturi × 2 (cheie și valoare) × 8 capete × 128 de numere × 2 octeți în f16, adică 147.456 de octeți, 144 KB pentru fiecare token din conversație. Datorită celor 8 capete de chei și valori în loc de 32, cache-ul este de patru ori mai mic decât ar fi fost la un model clasic de aceeași mărime.
| Fereastra de context | KV cache (f16, teoretic) | Observație |
|---|---|---|
| 4.096 tokeni | 0,58 GB | valoarea implicită în Ollama |
| 8.192 tokeni | 1,15 GB | |
| 32.768 tokeni | 4,6 GB | contextul nativ al modelului |
Ollama pornește cu o fereastră de 4.096 tokeni, conform documentației oficiale. Tot ce depășește fereastra, de obicei începutul conversației sau al documentului lipit în prompt, este tăiat fără avertisment vizibil, iar modelul pare să „uite”. Fereastra se schimbă cu /set parameter num_ctx 16384 în terminal, cu num_ctx în opțiunile API sau global cu variabila de mediu OLLAMA_CONTEXT_LENGTH. Cache-ul poate fi și el cuantizat, cu OLLAMA_KV_CACHE_TYPE setat la q8_0 sau q4_0, când Flash Attention este activ.
Ultimul pas: de la 4.096 numere la un cuvânt
După stratul 36, vectorul tokenului curent trece printr-o ultimă RMSNorm și se înmulțește cu matricea de ieșire, de 4.096 × 151.936. Rezultatul este un rând de 151.936 scoruri, câte unul pentru fiecare token din vocabular. Scorurile se numesc logits.
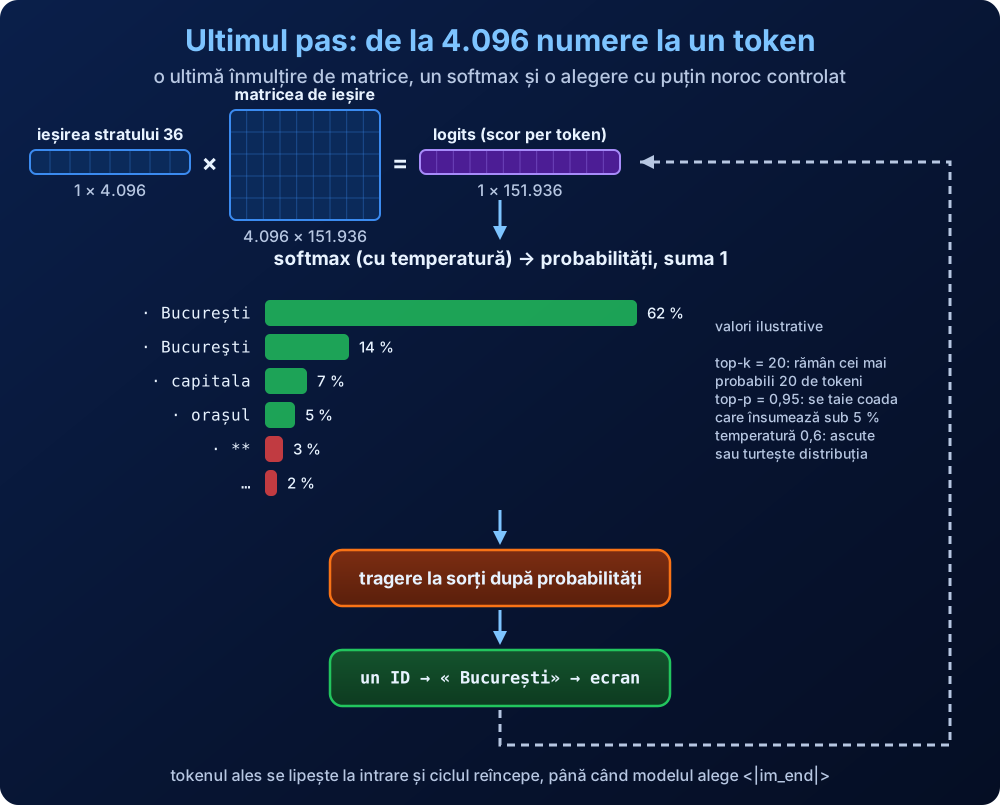
Un softmax le transformă în probabilități, dar cu un parametru în plus: temperatura. Scorurile se împart la temperatură înainte de exponențială. O temperatură mică face distribuția ascuțită, aproape întotdeauna câștigă tokenul cel mai probabil; una mare o turtește și lasă loc variantelor mai rare. Apoi se aplică două filtre: top-k păstrează doar cei mai probabili k tokeni, top-p taie coada distribuției care însumează sub un prag. Din ce rămâne se trage la sorți, proporțional cu probabilitatea.
Qwen recomandă în fișa modelului temperatură 0,6, top-p 0,95 și top-k 20 pentru modul cu gândire, respectiv 0,7, 0,8 și 20 fără gândire, și avertizează explicit să nu se folosească alegerea strict deterministă a celui mai probabil token, pentru că produce repetiții. De aici vine și faptul că același model dă răspunsuri diferite la aceeași întrebare: este o tragere la sorți, controlată. Cu parametrul seed fixat, aceeași secvență de numere aleatoare dă același răspuns.
Tokenul ales se adaugă la intrare și bucla reîncepe: încă 36 de straturi, încă 151.936 scoruri, încă o alegere. Până la <|im_end|>.
De ce contează memoria mai mult decât procesorul
La decodare, pentru fiecare token nou, toate cele 5,2 GB de greutăți trebuie citite din memorie o dată. Calculul în sine este mic pentru un singur token; timpul se duce pe transportul numerelor. De aceea viteza de generare are un plafon simplu: lățimea de bandă a memoriei împărțită la mărimea modelului.
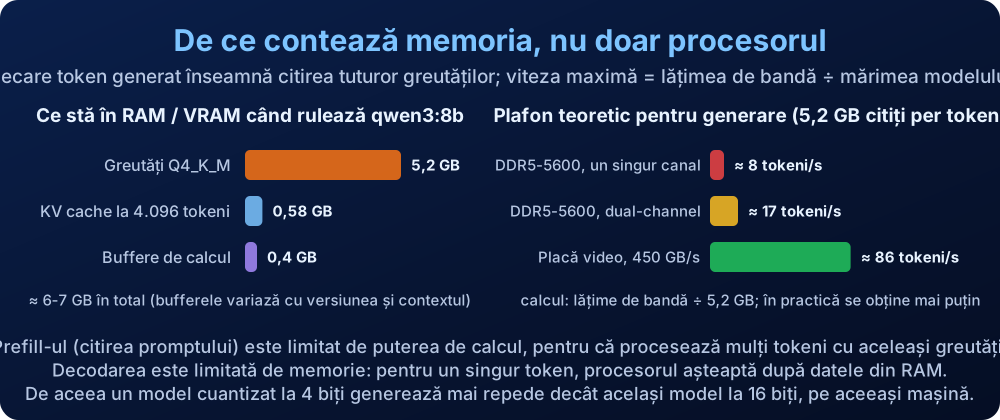
| Memoria în care stă modelul | Lățime de bandă | Plafon teoretic |
|---|---|---|
| DDR5-5600, un singur modul | 44,8 GB/s | 8,6 tokeni/s |
| DDR5-5600, dual-channel | 89,6 GB/s | 17,2 tokeni/s |
| Placă video de clasă medie | 450 GB/s | 86 tokeni/s |
Cifrele sunt plafoane teoretice, calculate ca lățime de bandă împărțită la 5,2 GB; în practică se obține mai puțin, din cauza KV cache-ului, al sincronizărilor și al faptului că procesorul nu atinge lățimea de bandă maximă. Nu am măsurat qwen3:8b pentru acest articol pe o configurație anume, deci nu publicăm valori măsurate. Dar ordinea de mărime explică două lucruri pe care le vedem la clienți. Primul: un mini PC cu un singur modul de memorie generează text la jumătate din viteza aceluiași PC cu două module. Al doilea: un model cuantizat la 4 biți este de aproape trei ori mai rapid decât același model la 16 biți, pentru că transportă de trei ori mai puțini octeți pe token.
Prefill-ul se comportă invers. Promptul are mulți tokeni care folosesc aceleași greutăți, deci fiecare număr citit din memorie este refolosit de n ori. Acolo contează puterea de calcul, iar o placă video face diferența de zeci de ori.
Cum verifici pe calculatorul tău
Toate cifrele din articol se pot confrunta cu ce raportează Ollama local.
- Instalează Ollama de pe ollama.com și rulează
ollama pull qwen3:8b. - Rulează
ollama show qwen3:8b. SecțiuneaModelafișează arhitecturaqwen3, parametrii8.2B, lungimea contextului, lungimea embedding-ului4096și cuantizareaQ4_K_M. - Pornește o conversație cu
ollama run qwen3:8b --verbose. După fiecare răspuns aparprompt eval count,eval countși vitezele în tokeni pe secundă. Prima valoare este numărul de tokeni ai promptului, a doua numărul de tokeni generați, inclusiv blocul de gândire. - În aceeași sesiune,
/set nothinkoprește blocul de gândire, iar/set parameter num_ctx 16384mărește fereastra de context. Repetă întrebarea și comparăeval countși viteza. - Într-un al doilea terminal,
ollama psarată dacă modelul stă în memoria plăcii video, în RAM sau împărțit:100% GPU,100% CPUsau un procent din fiecare. - Pentru contabilitatea completă, apelează API-ul direct:
curl http://localhost:11434/api/generate -d "{\"model\":\"qwen3:8b\",\"prompt\":\"Ce este un LLM?\",\"stream\":false}"
Răspunsul conține prompt_eval_count, eval_count, prompt_eval_duration și eval_duration, din care calculezi viteza reală de prefill și de decodare a mașinii tale.
Unde nu se potrivește
Un model de 8 miliarde de parametri rulat local nu este un înlocuitor pentru modelele mari din cloud, și nici pentru o bază de date.
- Cunoștințe limitate și nesigure. Tot ce „știe” modelul este comprimat în cele 8 miliarde de numere, la rezoluție de 4 biți. Pentru fapte precise, date, cifre sau legislație, răspunsul poate fi plauzibil și greșit. Nu are acces la nimic după data antrenării și la nimic din firma ta, decât dacă îi pui documentul în prompt.
- Româna costă. Diacriticele și cuvintele rare se taie în mai mulți tokeni, deci textul românesc ocupă mai mult context și se generează mai încet decât cel englezesc. Calitatea în română este sub cea în engleză sau chineză, limbile dominante din antrenare.
- Fereastra implicită de 4.096 tokeni înseamnă aproximativ 8-10 pagini de text în română, inclusiv răspunsul. Un contract lipit în prompt este tăiat la început fără avertisment, dacă nu mărești
num_ctx. - Modul cu gândire consumă. Înainte de răspuns, Qwen3 poate genera sute sau mii de tokeni de raționament. Pe un procesor fără placă video, asta înseamnă minute de așteptare la întrebări simple.
- Răspunsurile nu sunt reproductibile fără
seedfixat, iar cuseedfixat sunt reproductibile doar pe aceeași versiune de Ollama și aceeași mașină.
Cum procedăm noi
La clienții care vor un asistent AI pe documentele interne, fără ca documentele să plece din firmă, folosim exact acest tip de model, prin Ollama, în Brio Argus. Documentele marcate on-premise nu sunt trimise niciodată la un furnizor cloud; modelul local primește în prompt doar fragmentele relevante găsite prin căutare hibridă, iar răspunsul vine cu citări numerotate care se deschid în sursă. Platforma include un benchmark între modele, cu care stabilim împreună cu clientul dacă un model de 8B pe hardware-ul existent este suficient sau dacă are sens o placă video ori un model din cloud pentru documentele care pot pleca.
Același Ollama local îl folosim în Brio Endpoint Manager pentru analiza AI a configurațiilor de pe servere și stații, acolo unde clientul nu vrea ca ele să ajungă la un furnizor extern.
Dacă vrei să rulezi un model local pe documentele firmei și nu știi ce hardware îți trebuie, scrie-ne ce mașină ai și cam câte documente. Îți spunem în câteva minute dacă un model de 8 miliarde de parametri este suficient și dacă merită un upgrade de memorie sau o placă video.
Întrebări frecvente
Este gratuit să rulez Qwen3 în Ollama?
Da. Ollama este open source, iar Qwen3 este publicat sub licență Apache 2.0, care permite utilizarea comercială fără taxe. Costul este doar hardware-ul și curentul. Pentru qwen3:8b ai nevoie de aproximativ 6-7 GB de memorie liberă, RAM sau VRAM, și de un procesor sau o placă video pe care Ollama le suportă.
Ce calculator îmi trebuie pentru qwen3:8b?
Modelul cuantizat ocupă 5,2 GB, plus KV cache-ul și bufferele, deci 16 GB de RAM sunt un minim confortabil pentru rulare pe procesor. Viteza depinde de lățimea de bandă a memoriei: două module de RAM în dual-channel dublează plafonul față de un singur modul. O placă video cu cel puțin 8 GB de memorie ține modelul integral în VRAM și generează de câteva ori mai repede decât procesorul.
De ce răspunde modelul diferit la aceeași întrebare?
Pentru că ultimul pas al generării este o tragere la sorți. Modelul calculează o probabilitate pentru fiecare token din vocabular, iar tokenul următor se alege aleator, proporțional cu aceste probabilități, după filtrele temperatură, top-k și top-p. Qwen recomandă această metodă și avertizează că alegerea strict deterministă a celui mai probabil token produce repetiții. Cu parametrul seed fixat, pe aceeași mașină și aceeași versiune de Ollama, răspunsul se repetă.
Modelul local trimite date pe internet?
Nu. După descărcare, Ollama funcționează complet offline: serverul ascultă implicit doar pe localhost:11434, iar modelul nu are nicio componentă de rețea. Promptul, documentele din el și răspunsul rămân pe mașina ta. Dacă expui serverul în rețea sau pe internet, protecția accesului este responsabilitatea ta, pentru că Ollama nu are autentificare proprie.
Merge Qwen3 și în română?
Da, româna este printre cele 119 limbi din datele de antrenare și modelul răspunde coerent. Două limite trebuie știute: diacriticele și cuvintele rare se taie în mai mulți tokeni, deci textul românesc ocupă mai mult context și se generează mai încet, iar calitatea rămâne sub cea din engleză, limba dominantă în antrenare. Pentru răspunsuri din documentele firmei, modelul se descurcă bine când fragmentele relevante îi sunt date în prompt.


